Kaon AI
在消费级 AI 产品达到一定规模之后,offline evaluation 并不是"不够好",而是已经在生产环境中失去决策意义。这一结论来自我们在千万级用户规模下的线上观察, 系统每月处理数 billion 级对话与行为反馈。
我们在真实用户环境中反复观察到:在公开创作类 benchmark 上排名靠前的模型,在实际用户使用中往往表现平平;而一些 offline 得分并不突出的模型,却能显著提升用户的留存、对话深度与继续率。在某些情况下,多个 benchmark Top-5 的模型,都会被一个 offline 排名明显靠后的模型稳定击败。
这不是偶发案例,而是结构性信号。
Offline benchmark 解决的是单一、离散的问题:任务边界清晰、存在标答。而 Consumer AI 面对的是连续性的内容消费体验——跨多轮对话、跨情境的整体感受。在娱乐与创作场景中,没有客观正确答案,只有用户偏好。因此,擅长评估离散任务的 benchmark,无法衡量也无法预测大规模用户的连续内容消费体验;它可以产生分数,但这些分数与真实用户行为之间并不存在稳定关系。
Offline evaluation 正在失效——不是因为 benchmark 设计得不够好,而是因为它们在根本上就不再适用于 Consumer AI。
即便是 Anthropic 在《Demystifying evals for AI agents》中,也尚未真正采用基于真实用户行为的 online evaluation。这恰恰说明:即使在最前沿的 AI 实验室中,评估范式依然停留在"局部、离散、事前定义成功标准"的阶段,而非面向大规模用户连续体验的在线闭环。这不是个别团队的问题,而是整个行业尚未跨过的范式门槛。
2026 年模型成本将持续下降,用户心智快速成熟,产品之间真正的差距,体现在谁能更快迭代、谁能更准确地判断"哪个模型应该被留下"。在这样的背景下,评估不再是辅助系统,而是决定产品上限的核心瓶颈——但在 C 端,至今仍然没有一套真正成熟、可规模化的评估方法论。
问题并不在于模型的回复"准不准",而在于什么才算成功。
Offline benchmark 的本质,是一套人为构造的任务:任务由人定义,grader 由人(或 LLM)设计,成功标准在实验开始前就已经被写死。这在受限场景中或许有效,但在大规模 Consumer AI 中,"事前定义成功"这件事本身,就是不可持续的。
这一点在内容型产品中早已有清晰验证。正如 Eugene Wei 在分析 TikTok 推荐系统时所指出的:系统并不是在理解内容"好不好",而是在通过持续观察用户行为,反向推断每个用户的偏好分布,并据此完成排序与分发。在这种机制下,行为本身就是唯一可规模化的信号,而任何试图事前定义"什么是好内容"的评估框架,都会在真实用户面前失效。
在 C 端 App 的环境下,用户的行为才是真正的 ground truth。
这正是 offline eval 在 C 端系统性失效的原因:它优化的是"看起来正确的答案",而用户奖励的,是"感觉正确的体验"。当评估体系与真实用户行为脱钩时,它可以产生分数,却无法支撑任何关键决策。
我们在 Emochi(创意小说场景)上看到一个非常直接的例子:在某个公开的 Creative Writing benchmark 排名前五的模型里,有多个模型上线后的用户留存明显低于一个 benchmark 排名远靠后的模型(例如 mistral-nemo)。这不是个例,而是一个信号:当"评分标准"与"用户偏好"不是同一个东西时,离线分数就会变成一种错觉。
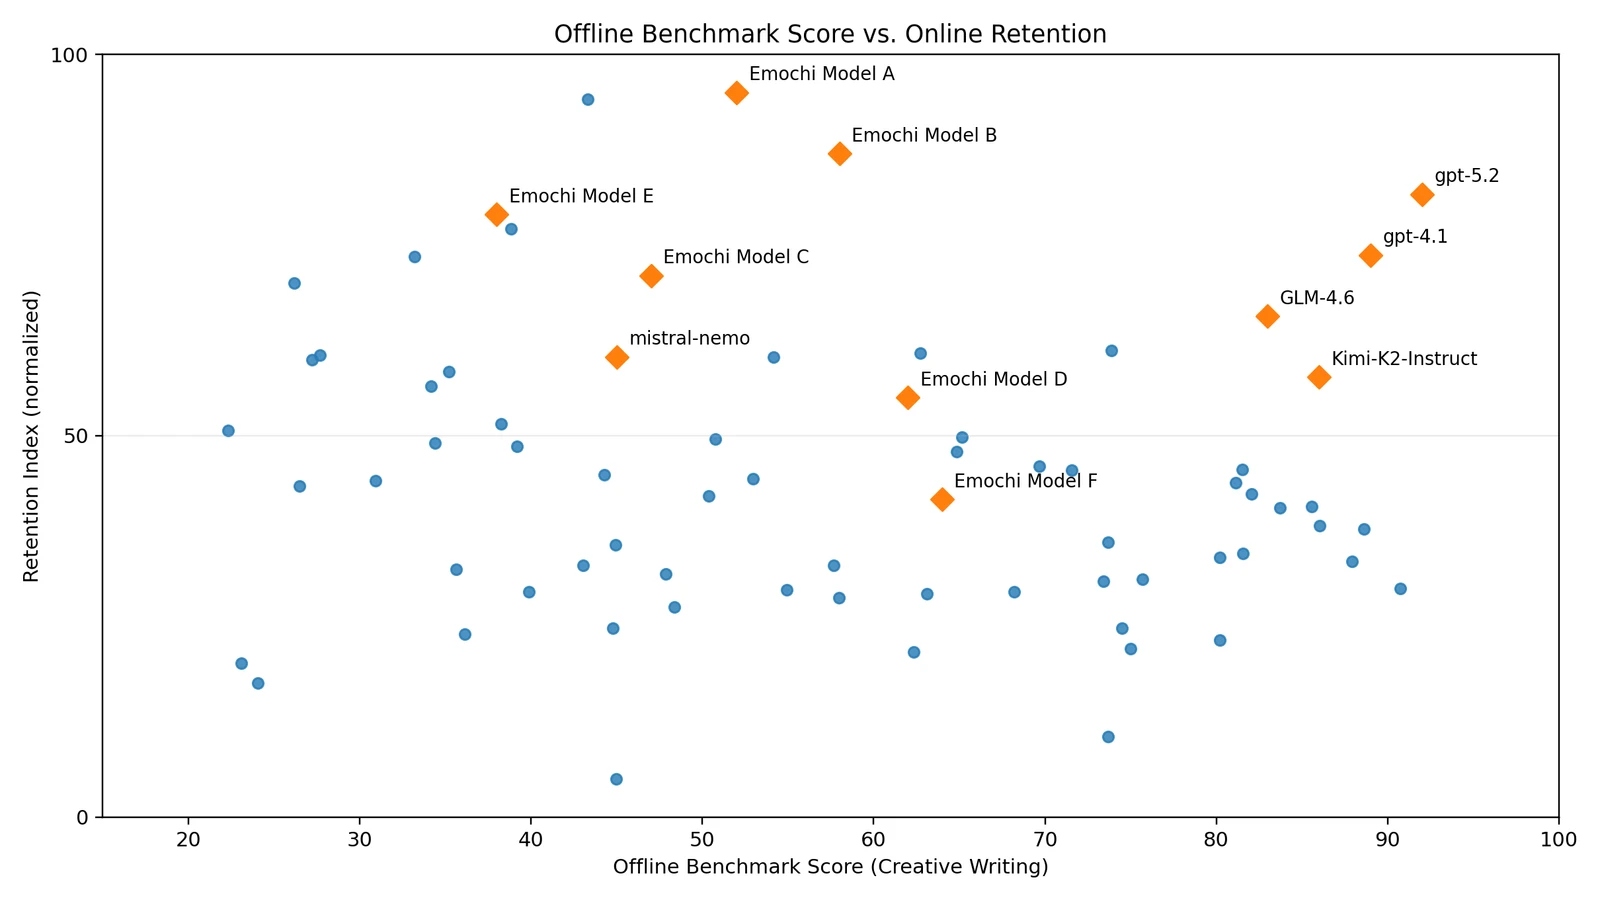
离线 Benchmark 分数 vs. 在线留存率
对于 Consumer AI 来说,一套无法由真实用户在线行为驱动的评估体系,并不是"不完整",而是不相关。可规模化的、基于真实用户反馈的 online evaluation infrastructure,不再是可选项——而是唯一的出路。
Evaluation Only Scales When It Is Closed-Loop
在 Consumer AI 场景下,模型评估不再是一个独立步骤,而是一条持续运行的闭环反馈系统。模型被部署、被使用、被比较、被筛选、被训练,最终又重新回到真实用户环境中接受验证。这条闭环的核心在于:所有关键评估信号,都来自真实用户的在线行为。
在我们的生产环境中,这一机制会稳定收敛为如下循环:
models → relative comparison (Elo) →
                decision → reward modeling (RM) → signal → models
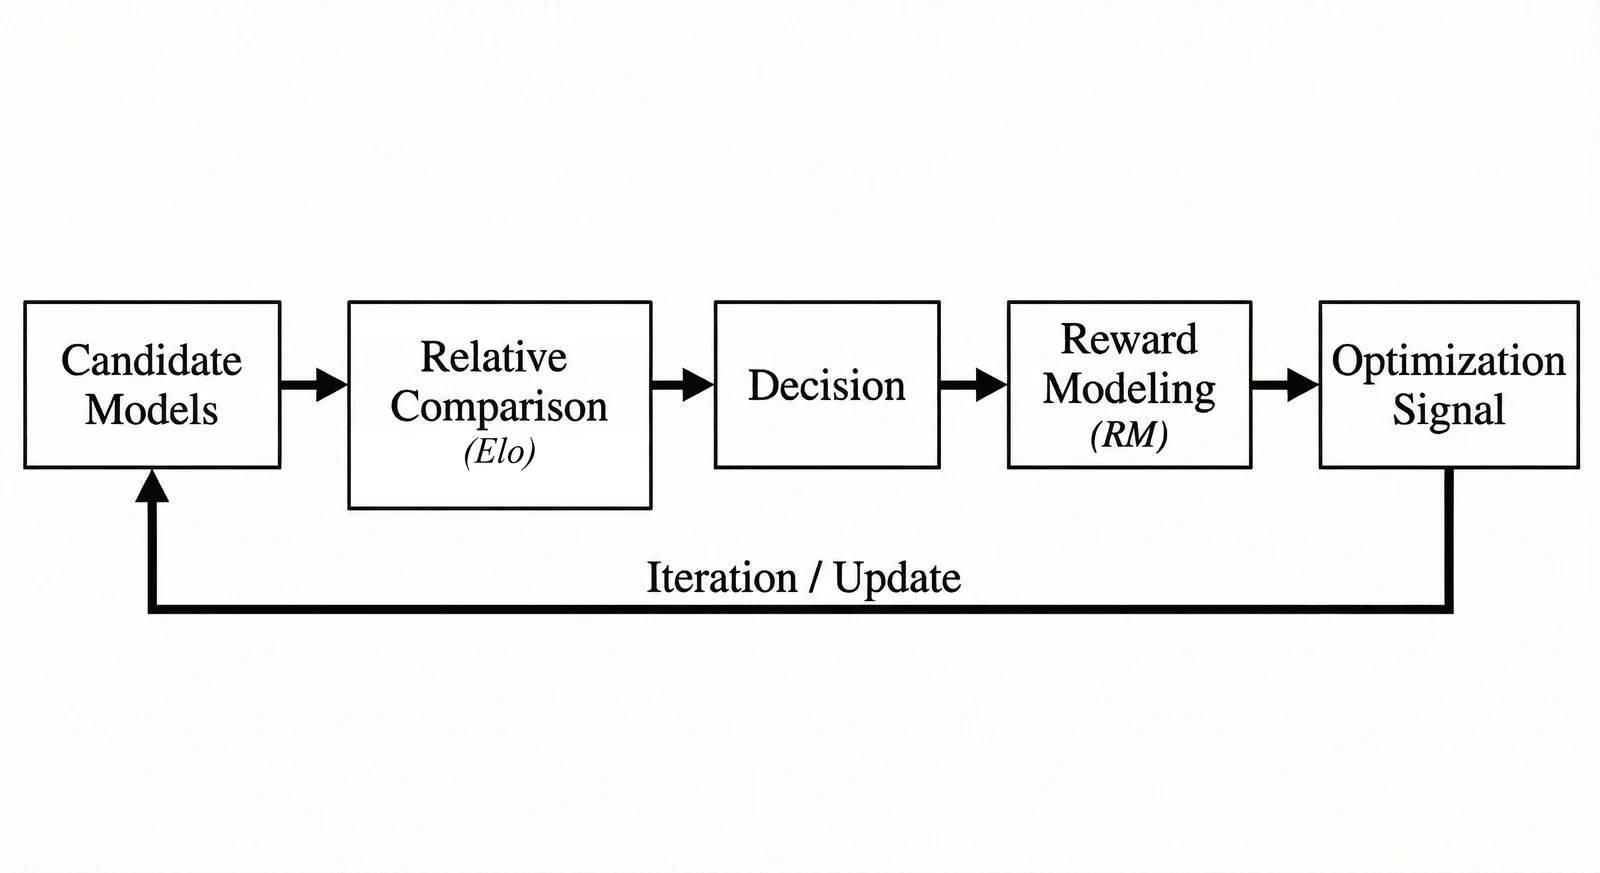
闭环评估系统
这条链路完全运行在真实用户数据之上,通过相对比较机制持续收集用户偏好信号;这些信号被聚合为可执行的模型决策,用于决定哪些模型应该被放量、保留或淘汰;同时,这些真实反馈又被进一步建模为面向产品场景的奖励信号,反向驱动下一轮模型训练与迭代。
在这个系统中,Elo 和 RM 并不是并列的评估工具,而是处在不同层级、解决不同问题的系统组件:
- Elo 解决规模问题
- RM 解决评估如何进入训练的问题
当这些组件被统一在同一条闭环中时,evaluation 不再是"验证模型好坏"的步骤,而成为驱动模型持续演化的基础设施。任何没有建立在真实用户行为之上的评估系统,最终都会优化一个已经不存在的产品。
Ranking Models by User Preference, Not by Static Scores
在这个阶段,评估系统面临的首要约束并不是统计精度,而是吞吐量与收敛速度。
传统 A/B 测试隐含了三个前提:评估对象稳定、实验窗口足够长、模型集合变化缓慢。但在真实的消费级 AI 生产环境中,这些前提几乎全部失效——新模型可能以天甚至小时为单位加入,而在一个传统 A/B 实验尚未收敛之前,候选模型往往已经过期。
相对排序系统(如 Elo,更准确地说是 TrueSkill)恰好适配了这种约束条件。它们被设计用于容忍噪声、不完整对战以及对手持续变化的环境,这些特性与线上流量场景高度一致。
因此,我们并不试图用 Elo 找到"全局最优模型",而是用它解决一个更工程化的问题:在当前流量与时间窗口下,哪些模型已经可以被明确排除。
更关键的是,我们并不把排序结果当作"绝对分数",而是把它当作一个带不确定性的在线估计:TrueSkill 用(μ, σ)显式表达"当前实力"与"置信度"。这使得系统可以在噪声不可避免、偏好持续漂移的前提下,仍然追求稳定的相对顺序——而不是追求一个看似精确、但在生产中并不可靠的单点分数。
为了让这套排序在长期运行中保持可控,我们把它当作基础设施来维护,而不是一次性实验:
- 对样本质量做基础过滤(例如剔除对战轮次过少导致的不稳定样本)
- 通过对数据合并与顺序扰动(shuffle)来检验排名的鲁棒性,避免"对战顺序"或短期噪声把系统推向错误结论
- 保留一组稳定的 reference 模型作为锚点:在模型池高速变化时,通过固定或半固定的参考模型来稳定评分尺度、校准新模型的冷启动,并减少整体 ranking 的漂移风险
需要强调的是:Elo/TrueSkill 的定位始终是 filter,而不是最终真理。它的价值在于用最低成本快速排除错误解,把更稀缺的评估与实验资源留给更有潜力的候选模型——而最终的上线与训练决策,会在后续的 A/B 与 RM 闭环中被进一步验证与优化。在当前流量下,我们通常可以在数小时内通过十万级对比样本淘汰明显不匹配的候选模型,把稀缺的更重评估资源留给 top pool。
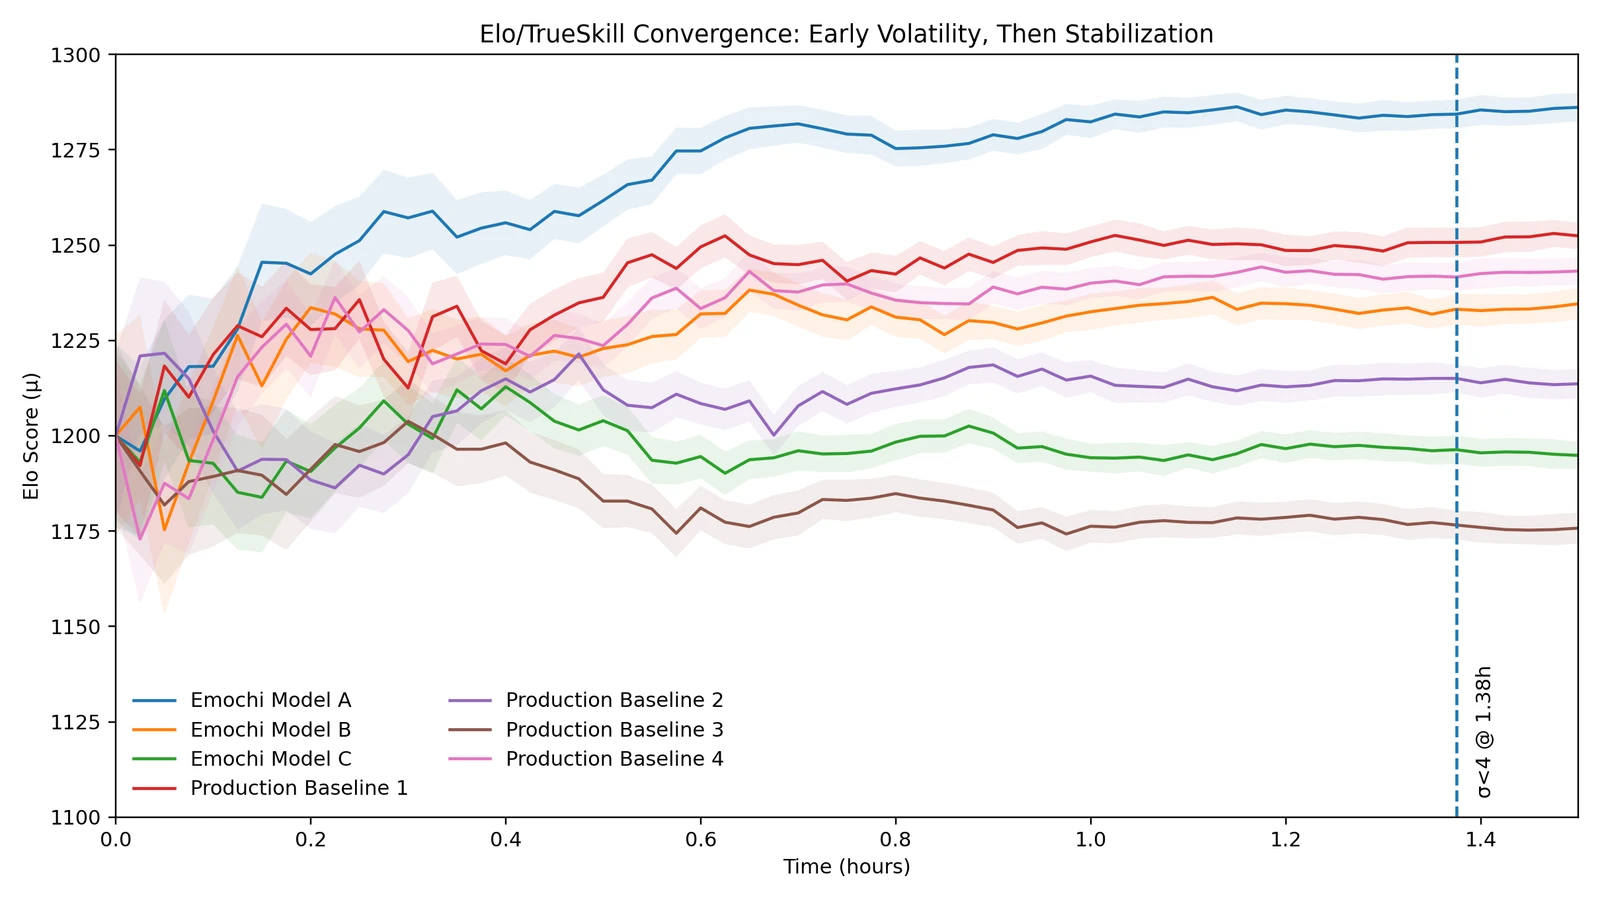
Elo/TrueSkill 收敛:早期波动,后期稳定
Turning User Behavior into a Learning Signal
如果评估只能告诉我们"哪个模型更好",却无法影响模型本身的演化,那么它终究只是一个事后解释系统,而不是生产系统的一部分。
在 Consumer AI 场景下,模型迭代的速度和频率决定了评估体系的价值上限。只有当评估信号能够被持续、稳定地回流到训练过程中,模型选择、模型优化与真实用户偏好之间,才会形成真正的闭环。
这条回流链路每天会沉淀亿级隐式标签与大量成对偏好样本,从而让 reward 信号具备可持续训练的密度与覆盖面。
这正是 RM(Reward Model)在整个系统中的角色。
与通用奖励模型不同,Emochi 的 RM 并不是从抽象偏好或人工标注出发,而是直接建立在真实用户行为之上。系统并不假设用户会显式告诉我们"什么是好模型",而是假设用户会通过行为不断暴露真实偏好。
这些行为信号包括但不限于:用户是否继续对话、下一轮 query 的长度、对模型回复的停留时长、显式的 like/dislike,以及在模型对战过程中的真实选择。这些信号在单次交互中可能是嘈杂的,但在规模化聚合后,它们被反复验证与长期留存和参与度高度相关。
关键在于,这些信号并不是被孤立使用的。RM 的作用,是将来自评估系统不同层级的用户反馈,统一映射到一个可学习的奖励空间中,使得模型训练能够直接对齐真实产品目标,而不是对齐某个静态的离线指标。
需要强调的是,RM 并不是一次性训练出来的模型,而是一个持续校准的系统。随着用户行为分布、产品形态和模型能力的变化,奖励信号本身也会发生漂移。系统的设计目标,并不是消除这种漂移,而是在漂移不可避免的前提下,保持奖励与真实用户价值之间的长期相关性。
当评估信号、模型决策和训练反馈被统一在同一条闭环中时,模型优化不再依赖离线假设,而是直接受到真实用户行为的持续约束。这使得整个系统能够在规模化运行中不断自我修正,而不是依赖周期性的人工校准。
在这个意义上,RM 并不是评估系统的附属模块,而是 consumer-scale online evaluation 成为"平台"的最后一块拼图:它让评估不再停留在选择层,而真正进入模型演化的动力层。
需要说明的是,这套闭环并不是从理论推导开始的。它是在 Emochi 的真实用户环境中,伴随模型规模、流量和产品复杂度的增长逐步成型的。在长期运行中,我们反复观察到:当评估决策真正交还给用户行为时,离线分数与核心业务指标之间的相关性会自然退居次要位置。
Trade-offs and Failure Modes
这套 scalable online feedback loop 并不是为了解决所有评估问题而设计的。它的目标非常具体,也因此做出了清晰的取舍。
首先,这套基础设施并不适用于所有阶段的产品。当产品规模尚小(例如 DAU < 50k)时,用户行为信号过于稀疏且噪声较大,难以支撑稳定的在线排序与决策。在这种情况下,human evaluation 或 offline 分析仍然可能是更高效的路径。但一旦产品跨过这一规模阈值,继续依赖 offline evaluation 就不再是"稳妥选择",而是一种滞后的系统设计。在真实用户环境中运行的 AI 系统,如果评估信号不来自真实用户行为,最终一定会与产品目标发生系统性偏移。
其次,这不是一套用于回答"模型在绝对意义上有多好"的评估体系。系统并不试图给出跨时间、跨场景、可复现的绝对分数,也不追求与传统 benchmark 的一一对齐。它关心的唯一问题,是在当前用户、当前分布、当前产品形态下,哪些模型更值得被继续放量和演化。
再次,这套系统并不假设用户反馈是干净、稳定或可解释的。相反,它从一开始就接受现实约束:用户行为是有噪声的,偏好是会漂移的,产品形态本身也在持续变化。系统设计的目标不是消除这些不确定性,而是在不确定性不可避免的前提下,持续降低决策风险。
最后,这不是一个"一次性评估"的解决方案。它无法在模型尚未进入真实使用场景之前给出确定结论,也无法替代研究阶段的离线分析。它存在的前提,是模型已经被部署、已经被真实用户使用,并且评估本身需要成为产品和训练流程的一部分。
正因为这些边界的存在,这套系统才能在 Consumer AI 的真实规模下长期运行。它放弃了对"静态真理"的追求,换取了对"持续决策"的可靠支持;放弃了对完美评估的幻想,换取了一个可以不断自我修正的生产级平台。
这正是我们所构建的:
不是一个评估工具,而是一条能够伴随模型与产品共同演化的反馈基础设施。